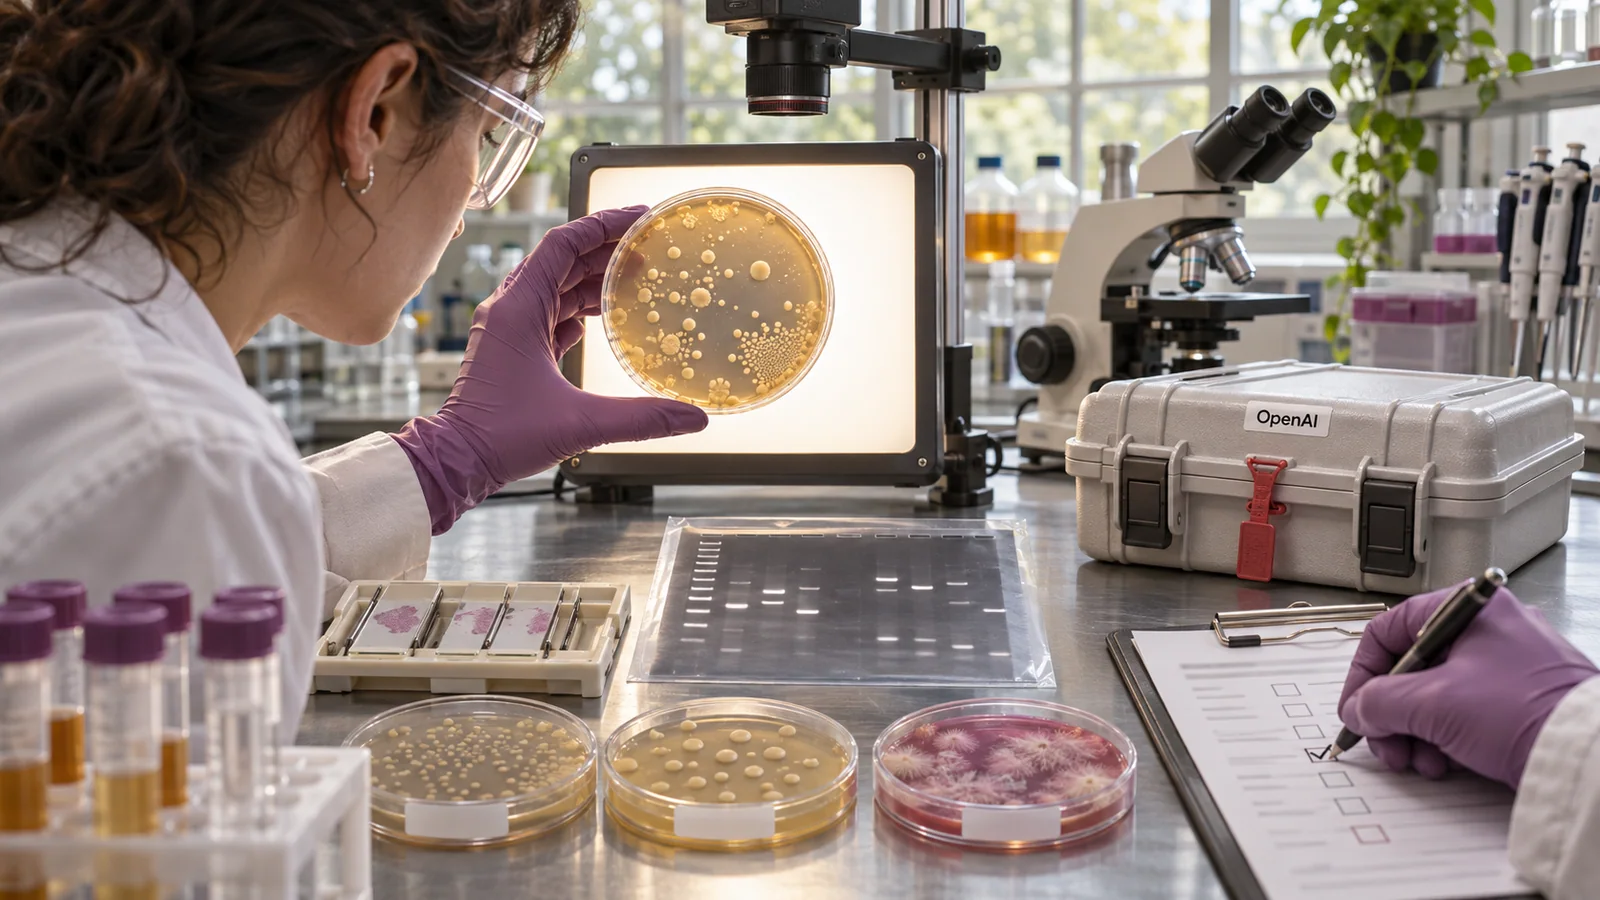
BioBasicsBench בוחן סוכני AI על 100 משימות המבוססות על ניסויי מעבדה אמיתיים. GPT‑6 Astra קיבל 66.7% מהניקוד האפשרי, אך המבחן מודד ניתוח נתונים בלבד ועדיין לא עבר אימות חיצוני רחב.
OpenAI ו-Ligo פרסמו ב-6 בנובמבר את BioBasicsBench, מבחן שמנסה לבדוק יכולת מעשית ומוגדרת: קריאה של חומר גלם ממעבדות ביולוגיות. הוא כולל 100 משימות שנבנו מנתונים של ניסויים אמיתיים, ובהם תמונות ג׳ל ו-Western blot, צלחות מושבות, ערימות מיקרוסקופיה, קריאות ריצוף, קובצי plate reader וסרטונים מעבודת המעבדה.
המשימות מחולקות לחמישה תחומים: שיטות חלבון, הדמיה וציטומטריה, כימות ובדיקות, שיטות חומצות גרעין ושיבוט מולקולרי. בכל משימה הסוכן צריך להציג מסקנה, מדידה או המלצה, ולעיתים גם את ההיגיון התומך בה. הניקוד ניתן לפי קריטריונים שכתבו מומחים. לפי OpenAI, כל משימה עברה בדיקה של מדען נוסף ב-Ligo, בדיקה חיצונית של מדען בעל דוקטורט שעובד במעבדה ובדיקה פנימית מסכמת.
מה הראה המבחן
OpenAI הריצה שבעה מודלים ב-37 שילובים של מודל ורמת מאמץ, חמש פעמים לכל אחת מ-100 המשימות. בסך הכול נוצרו 18,500 תוצאות. ברמת xhigh המשותפת לכל המודלים, GPT‑6 Astra קיבל בממוצע 66.7% מהניקוד האפשרי. GPT‑6.1 Sol קיבל 62.0%, ואילו GPT‑5.6 Sol קיבל 43.8%.
המספר מציין ממוצע של ניקוד חלקי לפי מחוון. הוא אינו שיעור ניסויים שהושלמו בהצלחה. Astra השתפר בזיהוי מצבים שבהם הנתונים אינם מספיקים למסקנה, למשל כששני צבעים פלואורסצנטיים חופפים באותו תחום קליטה. עם זאת, OpenAI מצאה שגיאות שנותרו בספירה, בבדיקת קבוצות ביקורת, בחיבור בין כמה מקורות מידע ובהסקת מסקנות שאינן נתמכות במלואן.
למי זה שימושי
למעבדות ביוטכנולוגיה, לחברות תרופות ולצוותים שבוחנים עוזרי מחקר, המבחן מספק משימות קרובות יותר לעבודה היומית מאשר שאלות ידע נקיות. אפשר להשתמש בו כדי לבדוק סינון ראשוני של תוצאות, איתור בקרות חסרות והכנת חומר לבדיקת מדען. הוא אינו בודק פיפטציה, תכנון ניסוי עצמאי או הפעלה בטוחה של ציוד.
בדיקה מקומית טובה תתחיל בתיקים היסטוריים שהמסקנה בהם כבר ידועה. מדענים יוכלו להשוות את תשובת הסוכן לבדיקה עיוורת של מומחה, לעבור על נקודות המחלוקת ולמדוד בנפרד טעויות בעלות סיכון שונה. כדאי לתעד אם הסוכן הצביע על הראיה שעליה הסתמך ואם אפשר לשחזר את הדרך למסקנה. תשובה שמבקשת הבהרה מיותרת אינה שקולה למסקנה בטוחה שאינה נתמכת בנתונים.
נשארו גם חוסרים מהותיים. הפרסום אינו מציג הורדה ציבורית מלאה של מערך הנתונים, ואינו מפרט את כל כלי העזר או הגישה החיצונית שהיו זמינים למודלים. אין עדיין תוצאות של מעבדות בלתי תלויות על אותן 100 משימות. לכן הנתונים מתאימים להשוואה בתוך הניסוי ש-OpenAI ו-Ligo ערכו; הם עדיין אינם בסיס להעברת החלטות מעבדה לסוכן ללא בדיקה אנושית.
מקורות

VibeTech
כתב/ת טכנולוגיה ב-VibeTech


