המודל החדש מתמלל הקלטות של עד שעה, מפריד בין דוברים ומקבל הוראות על סגנון התמלול. המשקלים פתוחים, אך זהו כלי לקבצים מוקלטים ולא לשידור חי, ונתוני הביצועים עדיין נשענים בעיקר על בדיקות NVIDIA.
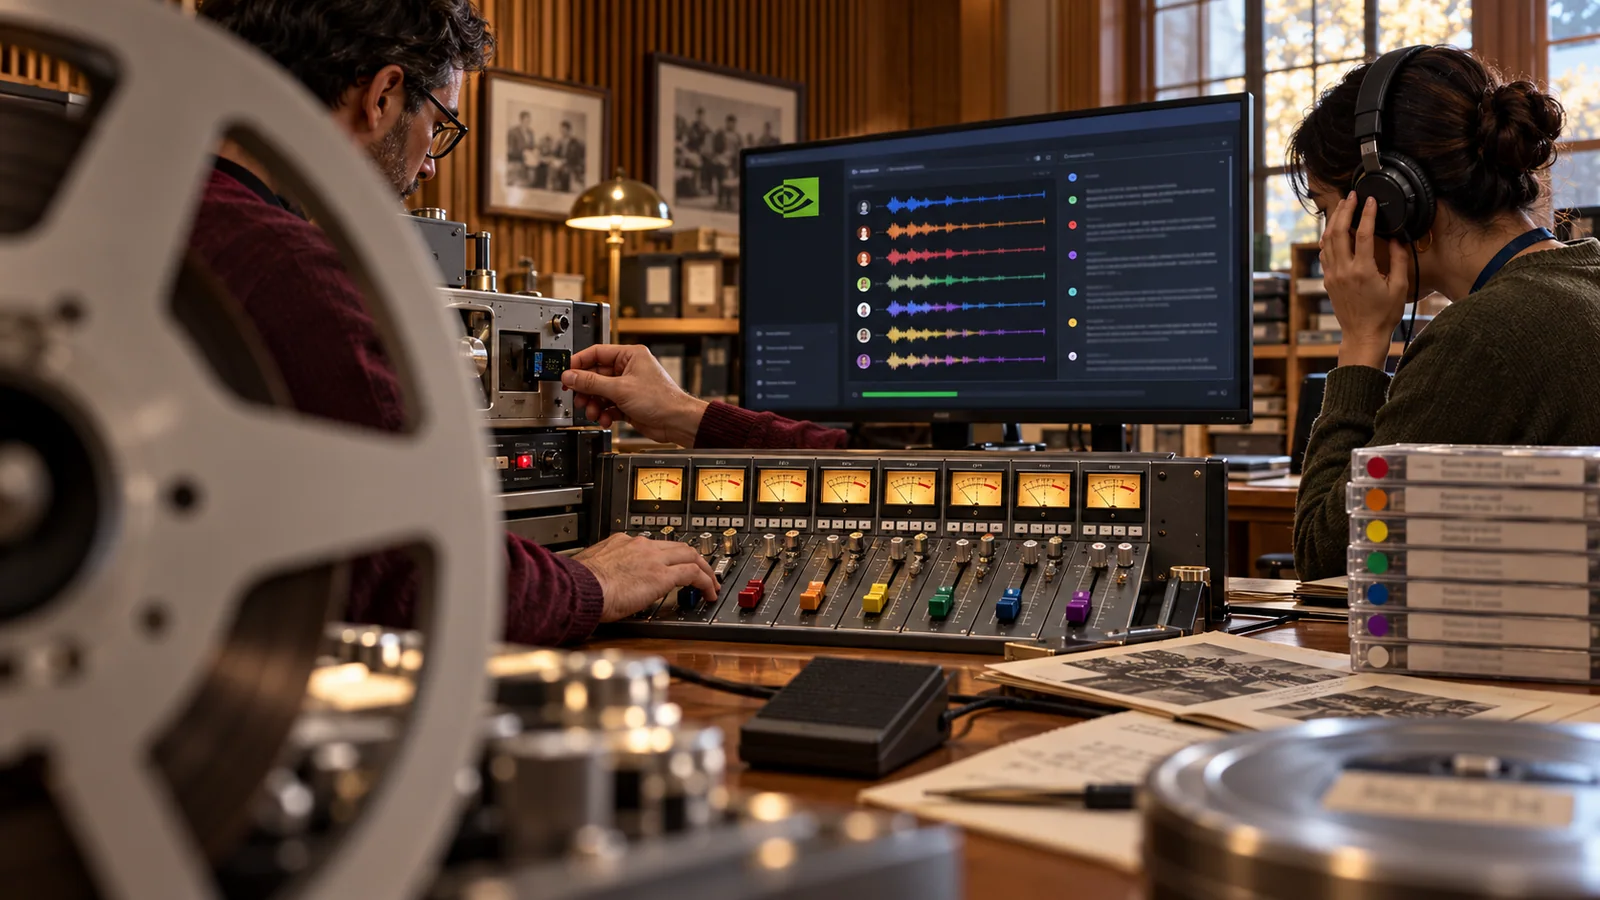
NVIDIA שחררה ב-28 באוקטובר את Nemotron 3.5 Transcribe, מודל בעל משקלים פתוחים שמיועד לתמלול של הקלטות קיימות. הוא תומך ב-40 שפות, מקבל קבצים באורך של עד שעה ויכול להחזיר תמלול עם סימון דוברים וחותמות זמן ברמת המילה. אפשר גם לבקש תרגום, זיהוי שפה או סגנון כתיבה מסוים באמצעות הוראה בשפה טבעית.
ההבדל המעשי ממערכת תמלול רגילה הוא השליטה בתוצאה. משתמש יכול לבקש תמלול מילולי עם מילות מילוי וחזרות, או גרסה נקייה יותר שמסירה היסוסים. אפשר לספק רשימת שמות ומונחים מקצועיים כדי לעזור למודל לזהות אותם, ולבקש הפרדה בין דוברים בשיחה צפופה. לפי NVIDIA, אותה נקודת בדיקה מטפלת במשימות האלה בלי צורך לאמן מודל נפרד לכל סגנון.
המודל משלב מקודד דיבור, מודל שמזהה פעילות של דוברים וגרסת Nemotron 3.5 Lightning בארכיטקטורת Mamba ו-Transformer. מתוך 34 מיליארד פרמטרים כוללים, כ-4.3 מיליארד פעילים בכל מעבר. המשקלים פורסמו ב-Hugging Face בכמה רמות דיוק, לצד כלי כוונון ב-NeMo Speech ורישיון OpenMDW-1.1. המודל מיועד להרצה עצמית ויכול לשמש צוותים שרוצים לשמור הקלטות בסביבה שבשליטתם.
נתוני הדיוק דורשים קריאה זהירה. NVIDIA מדווחת על שיעור שגיאת מילים ממוצע של 4.71% בתשעה מערכי בדיקה באנגלית ועל 4.62% במבחן רב-לשוני. החברה גם טוענת לשיפור גדול בזיהוי שמות כאשר ניתנת מראש רשימת ישויות. אלה תוצאות שפורסמו על ידי NVIDIA. הן לא אומרות שהמודל יהיה מדויק באותה מידה בעברית, בהקלטות רועשות, בשמות מקומיים או בשיחות שבהן כמה אנשים מדברים יחד.
גם נתון המהירות הגבוה ביותר, עד 2,238 שניות קול בשנייה על RTX PRO 6000 Blackwell, נמדד בסביבת NIM מותאמת עם גרסה מכווצת ומודל עזר. בכרטיס המודל NVIDIA מציינת שהאופטימיזציות האלה עדיין אינן חלק מלא מהקוד הפתוח, ושהשילוב הזמין למפתחים ביום ההשקה צפוי להיות איטי בערך פי שניים. צוות שבוחן התקנה צריך למדוד את הגרסה והחומרה שבאמת יהיו בשימוש.
איפה זה שימושי ואיפה לא
Nemotron 3.5 Transcribe יכול להתאים לארכיונים, ישיבות, שיחות שירות והקלטות מקצועיות שבהן חשוב לדעת מי אמר מה ומתי. הוא אינו שירות תמלול בזמן אמת. TechCrunch ו-The New Stack מדגישות שהוא עובד על הקלטות ולא על זרם קול חי, ולכן אינו תחליף ישיר לכתוביות מיידיות או לסוכן קולי שמגיב במהלך שיחה.
הבדיקה הטובה ביותר היא על מדגם מקומי שכולל מבטאים, רעש, שמות ומונחים אמיתיים. צריך למדוד דיוק, עקביות בסימון דוברים, זמן עיבוד, צריכת זיכרון ותנאי הרישיון. חשוב לזכור שסימון דובר מבדיל בין קולות בתוך ההקלטה, אך אינו מזהה אדם בעולם האמיתי. ההשקה נותנת למפתחים בסיס פתוח וגמיש, אך עדיין חסרה הערכה עצמאית רחבה שתראה איך הוא מתנהג מחוץ למערכי הבדיקה של החברה.
מקורות
VibeTech
כתב/ת טכנולוגיה ב-VibeTech