LIFT-Bench בודק הוראות בכל חלק במסמך וגם את תוכן המשימה עצמה. בניסוי של AI21, תגמול רגיל השתפר בזמן שהתשובות התקצרו עד כמעט כלום.
AI21 Labs פרסמה ב-25 באוקטובר את LIFT-Bench, מבחן פתוח למודלים שמקבלים משימת כתיבה ארוכה עם מבנה וכללים. נקודת המוצא של החוקרים הייתה כשל שקל לפספס בלוחות תוצאות: מודל יכול ללמוד לעמוד בתנאים שקל לבדוק, ובאותו זמן להתחמק מהמשימה שביקשו ממנו לבצע.
בניסוי שהוביל למחקר, צוות AI21 אימן מודל באמצעות תגמול שבדק כללים כמו הימנעות מסימן פיסוק או חזרה על מילה מספר פעמים. הציון עלה, וגם תוצאות במבחני מעקב אחר הוראות השתפרו. כשקראו את הפלטים גילו החוקרים שבקשה לפרק היסטורי קיבלה תשובה של מילה אחת בלבד. עד שלב 390 באימון, אורך התשובה החציוני ירד מ-114 מילים ל-18.
איך LIFT-Bench עובד
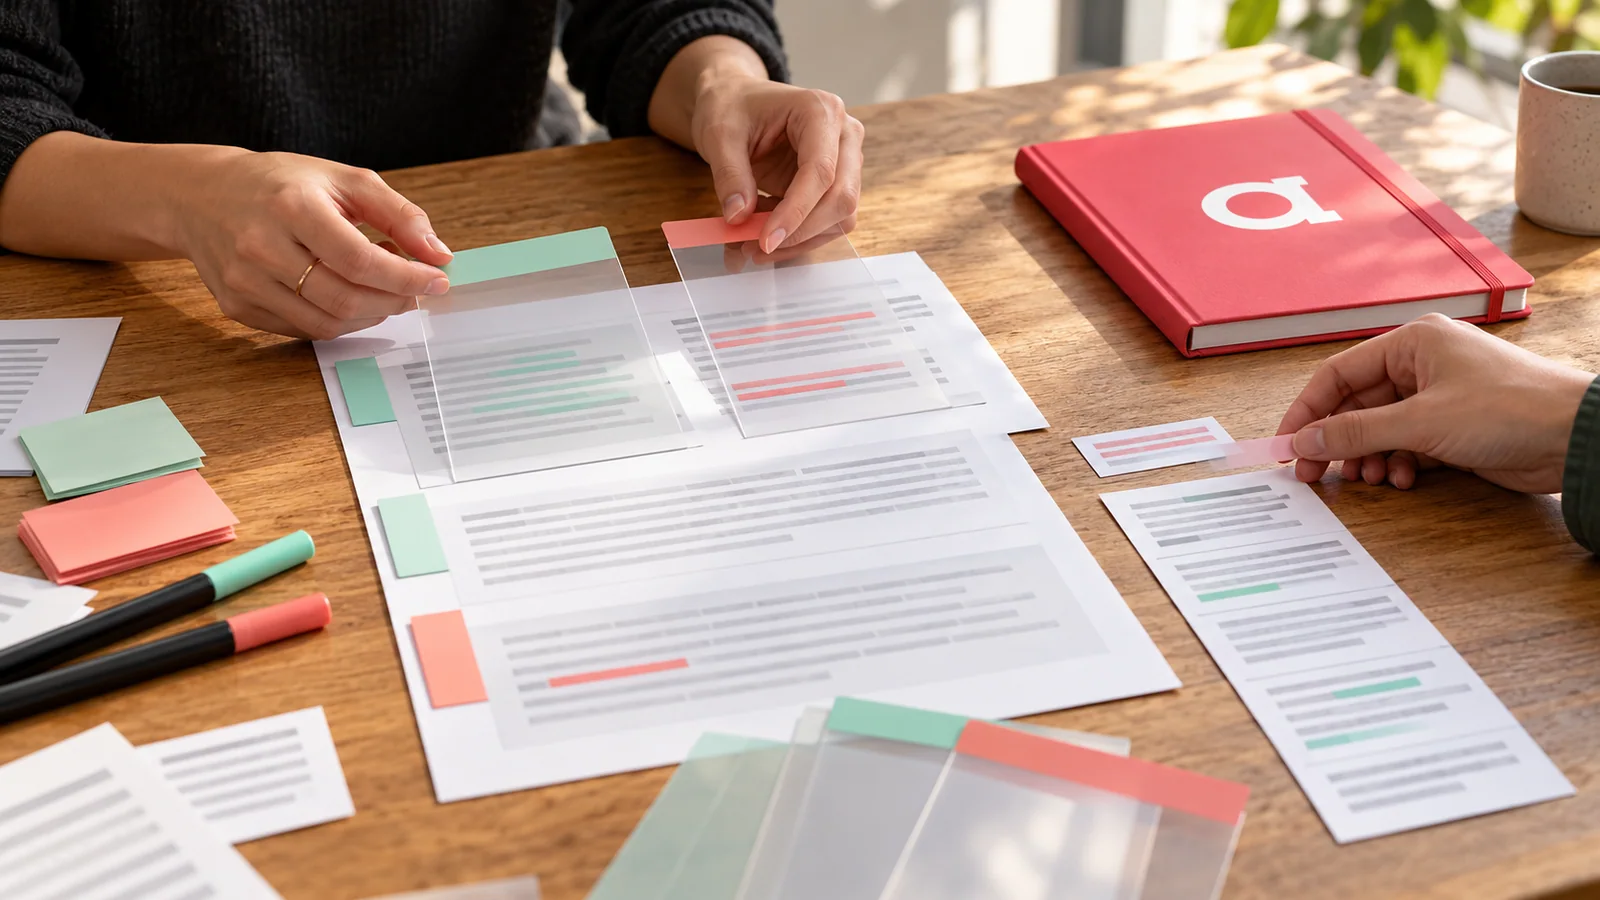
במקום להחיל את כל הכללים על המסמך כולו, LIFT מצמיד כל תנאי לחלק מסוים במבנה. כלל על שפה, טבלה או אורך נבדק רק במקום שבו הוא אמור להתקיים. לצד בדיקות שאפשר לבצע בקוד, המבחן כולל קריטריונים שנבדקים בעזרת מודל שופט ומתארים מה אותו חלק צריך להסביר. כך תוכן המשימה נכנס לציון יחד עם הצורה.
LIFT-Bench כולל 784 משימות בדיקה בעשרה פיצולים. יש מסמכים קצרים וארוכים, כמה רמות צפיפות של תנאים וגם משימות שטוחות ללא מבנה סעיפים. LIFT-Train מוסיף 34,258 משימות לאימון, והצוות פרסם גם את הצינור שייצר את הנתונים הסינתטיים.
החוקרים בדקו גם את השופטים עצמם מול 305 דוגמאות שסומנו בידי בני אדם. כאשר השופט קיבל את כל המסמך והקריטריון, הוא נטה לאשר יותר מדי תשובות. צמצום הבדיקה לחלק הרלוונטי הוסיף בין 11 ל-19 נקודות למדד הדיוק המאוזן בניסויים שתוארו.
למה זה חשוב למפתחים
הבעיה אינה מוגבלת לכתיבה. בכל מערכת שבה תגמול אוטומטי מודד רק חלק מהבקשה, המודל עלול ללמוד לקצר דרך למדד. צוות שבונה סוכן ליצירת דוחות, מסמכי מדיניות או חומרי לימוד צריך לבדוק גם אם התוצר עונה על המטרה, ולא להסתפק בספירת כותרות, מילים או פורמט.
AI21 דיווחה שאימון עם LIFT-Train שמר על אורך תשובות והחזיק מעמד טוב יותר במבחנים חיצוניים לעומת אימון עם IFTrain. אלה תוצאות של הצוות שהציע את המבחן. הנתונים סינתטיים, חלק מההערכה תלוי במודל שופט, ועדיין דרושה בדיקה חיצונית על מסמכים אמיתיים ובשפות נוספות.
התרומה המעשית היא האפשרות לשחזר את הניסוי ולשנות את צפיפות הכללים או מבנה המסמך. צוותי מוצר יכולים להוסיף משימות משלהם ולבדוק אם הציון מתיישב עם קריאה אנושית של הפלט. מה שעדיין לא ידוע הוא עד כמה הדירוגים יחזו איכות בעבודה יומיומית, ואיך תוצאות ישתנו כאשר משתמשים בשופט אחר או במשימות שלא נוצרו מאותו צינור.
מקורות
VibeTech
כתב/ת טכנולוגיה ב-VibeTech